Indexación automática con IA en un data room: cómo se ordenan, etiquetan y revisan los archivos
En esta página
- Qué hace realmente la indexación automática
- El recorrido de un archivo
- Qué tareas resuelve bien y cuáles no
- Los errores que aparecen en operaciones reales
- IA, archivado manual o plantilla
- La revisión que vuelve segura la indexación
- Privacidad cuando un modelo lee tus documentos
- Qué probar durante la prueba gratuita
- Quién debería apoyarse en la indexación y quién ir más despacio
En casi cualquier demostración vas a escuchar la misma promesa: sube la carpeta completa y la sala se ordena sola.
Es verdad a medias.
La mitad verdadera impresiona. Un data room moderno toma unos miles de archivos mezclados, lee los escaneados, deduce que un scan_0042.pdf es en realidad un contrato de arrendamiento, lo numera, lo etiqueta con el inmueble y el arrendatario, y avisa que ese mismo contrato se subió dos veces desde dos computadoras distintas. Lo que antes le costaba una semana a un asistente legal ahora ocurre mientras preparas un café.
La mitad falsa es la que lastima operaciones. La sala no sabe que una carta complementaria modifica el contrato que archivó tres carpetas más arriba. No sabe que un contrato laboral corresponde a un directivo clave cuyas condiciones el vendedor solo quiere mostrar al finalista. Y no tiene idea de que al índice le falta una categoría completa de documentos que el abogado del comprador va a pedir el segundo día.
Por eso conviene reemplazar el mito por una frase más útil.
La IA no organiza tu sala. Redacta una organización, rápido y casi siempre bien, y alguien que entiende la operación tiene que revisarla.
Esta guía explica qué le pasa a un archivo entre la subida y su lugar definitivo en el índice, qué pasos son fiables, cuáles fallan y cómo hacer una revisión que atrape los errores importantes antes de que una contraparte los vea.
Qué hace realmente la indexación automática
La indexación automática con IA es la lectura, clasificación, rotulado y control automatizados de los documentos que entran a un data room virtual, para que cada archivo termine numerado, etiquetado y ubicado en un índice del data room con muy poco trabajo manual.
Detrás de ese nombre hay cuatro trabajos distintos, y cada proveedor los empaqueta a su manera.
Extracción de texto. Antes de clasificar, el sistema necesita texto legible. Los PDF nativos y los archivos de oficina ya lo traen; los escaneos y las fotos requieren reconocimiento óptico de caracteres. Todo lo que sigue depende de este paso, incluida la búsqueda de texto completo.
Clasificación. El sistema decide qué tipo de documento tiene delante (un arrendamiento, un acta de directorio, una nómina, un acuerdo de confidencialidad) y propone una carpeta. Las salas más antiguas lo hacían con reglas y listas de palabras; las nuevas usan modelos de lenguaje que leen las primeras páginas e infieren el tipo por contexto.
Nombres, numeración y etiquetas. El archivo recibe un título limpio, un número de índice coherente con su carpeta y etiquetas como contraparte, fecha, jurisdicción o activo.
Controles de calidad. La última capa busca problemas: duplicados exactos y casi exactos, archivos protegidos con contraseña o dañados, páginas sin texto, borradores que parecen versiones firmadas y, en los productos más ambiciosos, huecos frente a una lista de due diligence.
Cuando compares productos, pregunta cuáles de los cuatro cubre la función. El nombre comercial casi nunca lo dice.
El recorrido de un archivo
Imagina a la directora financiera de una cadena de farmacias con sede en Bogotá que, un viernes por la tarde, arrastra un zip de 2.400 archivos a una sala nueva. Dentro está IMG_7731.jpg, una foto tomada con el celular de un contrato de arrendamiento firmado de una bodega en Medellín.
Primero, la sala descomprime el archivo y guarda la ruta original como metadato, aunque luego mueva el documento. Las buenas salas conservan ese rastro.
Segundo, el OCR lee la foto. La imagen está algo torcida y el bloque de firmas queda en sombra, así que la primera página sale limpia y la última, con huecos. El sistema registra un nivel de confianza.
Tercero, la clasificación. El modelo lee “arrendador”, “inmueble” y una tabla de cánones, y propone con alta confianza la carpeta de arrendamientos.
Cuarto, las etiquetas. Extrae el nombre del arrendador, la dirección y la fecha de inicio. No logra leer la fecha de vencimiento, porque esa cláusula está en la página sombreada, y deja la etiqueta vacía.
Quinto, los controles. Detecta que un PDF llamado Arriendo bodega firmado.pdf tiene un texto casi idéntico y marca ambos como posibles duplicados. No detecta que un otrosí de dos páginas, archivado como correspondencia porque su primer párrafo habla de una reunión, prorroga ese arrendamiento por cinco años.
Todo pareció un éxito. Y el dato más importante del contrato, su plazo real, quedó repartido en dos carpetas sin ningún vínculo.
Si la operación termina en disputa, el comprador dirá que el plazo real nunca estuvo a la vista. Y tendrá parte de razón: estaba en la sala, pero en un lugar donde nadie lo iba a buscar.
Ese es el fallo típico. La indexación automática rara vez produce caos; produce una estructura ordenada, segura de sí misma y ligeramente equivocada.
Qué tareas resuelve bien y cuáles no
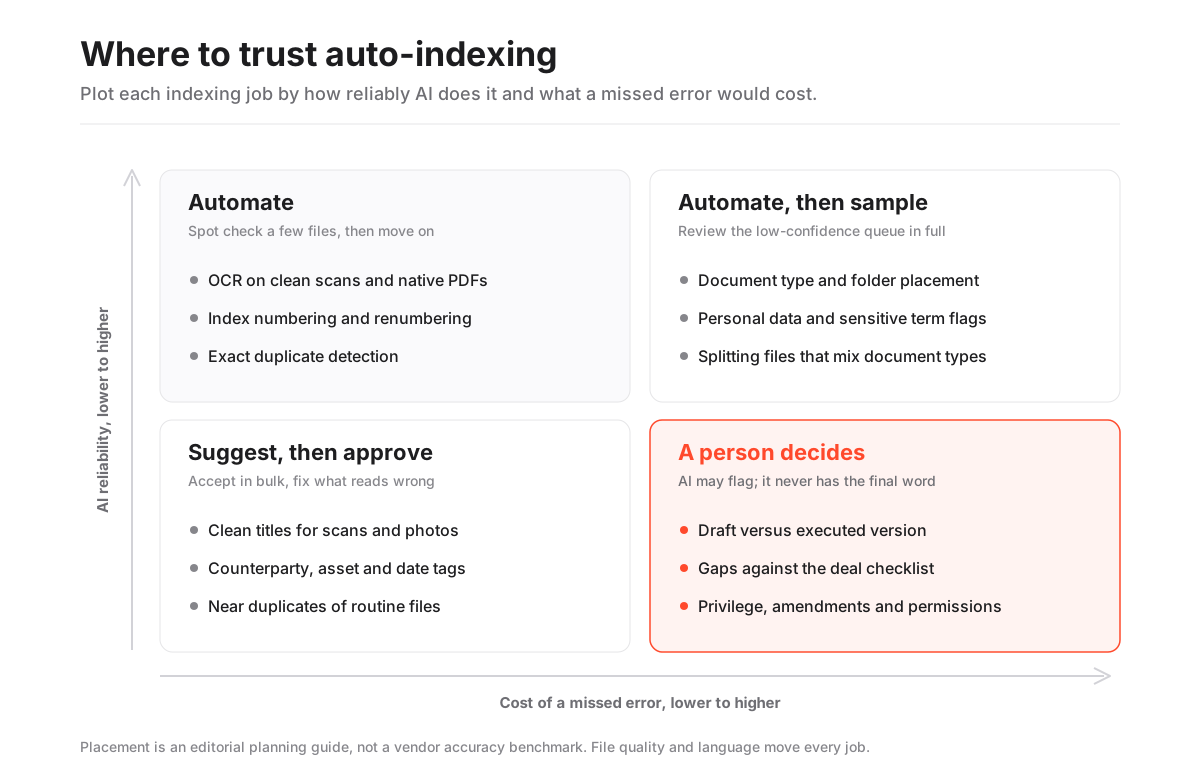
La fiabilidad cambia mucho más según la tarea que según el proveedor. Esta tabla resume nuestro criterio editorial a partir de pruebas con salas que ofrecen indexación asistida; úsala para decidir dónde poner el tiempo de revisión, no como ranking de productos.
Tareas de indexación según fiabilidad habitual y costo de un error
| Tarea | Fiabilidad habitual | Dónde falla | Costo de un error no detectado |
|---|---|---|---|
| OCR en escaneos limpios y PDF nativos | Alta | Letra manuscrita, sellos, fotos torcidas, tablas | Bajo a medio: el archivo no se encuentra en búsquedas |
| Numeración y renumeración del índice | Alta | Ajustes manuales que el sistema vuelve a numerar | Bajo, aunque rompe referencias en las preguntas y respuestas |
| Duplicados exactos | Alta | El mismo documento con portada o tamaño distinto | Bajo: desorden y tiempo perdido |
| Clasificación por tipo de documento | Media a alta | Cartas breves, otrosíes, paquetes mixtos, otros idiomas | Medio a alto: hereda los permisos de la carpeta equivocada |
| Etiquetas de partes y fechas | Media | Términos definidos, anexos, fechas escritas en letras | Medio: los reportes de vencimientos fallan en silencio |
| Versiones y borradores | Media | Borradores con comentarios frente a copias firmadas | Alto: el comprador lee el borrador como si fuera lo pactado |
| Huecos frente a la lista de due diligence | Baja a media | Documentos que simplemente no se subieron | Alto: aparece en la ronda de preguntas o después de firmar |
| Datos personales y términos sensibles | Media | Nombres en tablas, identificaciones en imágenes | Alto: exposición de privacidad ante la parte equivocada |
Lee primero la última columna. Las tareas más fiables son también las de menor riesgo, y las de mayor riesgo son justo aquellas donde el modelo duda más. Esa inversión es la razón de ser de la revisión.
La clasificación merece atención especial. En la mayoría de las salas los permisos se asignan por carpeta, así que un documento mal archivado no solo se ve desordenado: hereda las reglas de acceso de su nueva carpeta.
Los errores que aparecen en operaciones reales
Los otrosíes se separan de su contrato. Un documento corto que modifica otro suele leerse como correspondencia. Se archiva solo y el comprador termina leyendo las condiciones originales como si fueran las vigentes.
Los paquetes mixtos reciben una sola etiqueta. Un PDF escaneado con un acta, dos resoluciones y un título de acciones se clasifica según lo que domine las primeras páginas, y el título de acciones desaparece dentro de gobierno corporativo.
Los borradores pasan por versiones finales. Un borrador con comentarios y el contrato firmado pueden coincidir en un 98 por ciento. Nuestra guía sobre control de versiones en un data room explica cómo cortarlo de raíz.
Idiomas y formatos difíciles. Muchos clasificadores rinden peor fuera del inglés. Un contrato laboral en portugués de São Paulo, una escritura notarial mexicana o una hoja de cálculo sin texto le dan al modelo muy poco con qué trabajar.
Etiquetas vacías que nadie ve. Cuando el sistema no logra extraer un dato, muchas veces deja la etiqueta en blanco en lugar de marcarla como dudosa. Un reporte de vencimientos construido sobre esas etiquetas simplemente omite el contrato cuya fecha estaba en la página sombreada, y nadie se entera hasta que el comprador pregunta. Antes de usar cualquier filtro o reporte para tomar decisiones, revisa cuántos documentos de esa carpeta tienen el campo vacío.
El documento que no está. Un modelo clasifica lo que existe; lo ausente no tiene texto. La detección de huecos ayuda solo si la lista coincide con la operación.
La indexación automática casi nunca deja una sala desordenada. La deja con aspecto de terminada, y eso es peor, porque nadie revisa una sala que ya parece lista.
IA, archivado manual o plantilla
La elección real no es IA sí o no. Hay tres formas de construir un índice y las buenas salas combinan las tres.
Tres formas de construir el índice de un data room
| Método | Velocidad con más de 2.000 archivos | Consistencia | Capta matices de la operación | Mejor uso |
|---|---|---|---|---|
| Archivado manual del equipo | Lenta: días | Depende de cada persona | Sí, si quien archiva conoce la operación | Carpetas sensibles y revisión final |
| Plantilla de carpetas con archivado a mano | Media | Alta a nivel de carpeta | En parte: la plantilla fija expectativas | Operaciones recurrentes y carteras de activos |
| IA que archiva dentro de una plantilla | Rápida: minutos u horas | Alta en documentos rutinarios | Débil en otrosíes, privilegio y huecos | El grueso de los documentos y el OCR |
La combinación más sólida es la tercera fila apoyada en la segunda. Con una estructura de carpetas probada, la IA elige entre destinos conocidos en lugar de inventar un árbol, y sus errores son más fáciles de ver. Dejar que el modelo invente la estructura desde cero rompe además el vínculo con tu lista de due diligence.
Indexación automática con IA en un data room
A favor
- Reduce el primer archivado de una carga grande de días a horas
- Vuelve buscables los escaneos y fotos mediante OCR
- Aplica nombres y numeración coherentes a miles de archivos
- Detecta pronto duplicados exactos, archivos dañados y páginas ilegibles
En contra
- Archiva mal otrosíes y paquetes mixtos con mucha seguridad
- Puede tomar un borrador como versión vigente
- Una carpeta equivocada implica permisos equivocados
- Rinde peor en otros idiomas, hojas de cálculo y documentos solo de imagen
La revisión que vuelve segura la indexación
Una revisión práctica sobre unos miles de documentos ocupa una tarde concentrada de dos personas. Es el seguro más barato de toda la preparación. Hazla en este orden y antes de enviar una sola invitación externa.
- Fija la plantilla antes de subir. Define carpetas principales y numeración para que la IA ordene hacia tus destinos.
- Sube a un área de preparación. Usa un área de preparación que ninguna parte externa pueda ver.
- Vacía la cola de baja confianza. Revisa todas las sugerencias dudosas; suelen ser una fracción pequeña.
- Muestrea las seguras. Abre entre diez y veinte archivos al azar por carpeta principal. Si aparecen más de uno o dos errores, revisa la carpeta completa.
- Busca modificaciones. Rastrea “otrosí”, “adenda”, “modificación” y “carta complementaria” y ubica cada una junto al contrato que cambia.
- Divide los paquetes mixtos y vuelve a archivarlos por separado.
- Confirma a mano las versiones de los contratos materiales.
- Barre datos sensibles. Busca salarios, pasaportes, cédulas, RFC o CPF y términos médicos en carpetas que verá un grupo amplio.
- Compara con tu lista punto por punto: encontrado, no aplica o falta.
- Asigna permisos al final, cuando la estructura ya está estable. La guía de permisos en un data room repasa los niveles.
Cierra con dos firmas: alguien del equipo de la operación confirma estructura y versiones, y alguien que conoce el material sensible confirma que nada queda expuesto. El registro de auditoría mostrará las cargas; tu acta de revisión mostrará el control.
Privacidad cuando un modelo lee tus documentos
Indexar con IA significa que un software lee cada página que subes, con datos personales de empleados, clientes o arrendatarios incluidos. Antes de la carga masiva, aclara dos cosas.
La primera es dónde ocurre el procesamiento: dentro del entorno del proveedor o a través de un servicio de modelos de terceros. Ambas opciones pueden ser válidas, pero la respuesta debe constar por escrito. En España rige el RGPD, con sus reglas sobre encargados y transferencias internacionales; en Brasil, la LGPD; en Colombia, la Ley 1581 de 2012; en México, la ley federal de protección de datos personales en posesión de particulares. Nuestra guía de residencia de datos detalla qué preguntar.
La segunda es si tus documentos se usan para entrenar algún modelo. La respuesta que buscas es un no contractual, que cubra tanto los modelos del proveedor como cualquier servicio del que dependa.
Hay un riesgo más discreto: una etiqueta o un resumen extraído es un dato nuevo derivado de un documento confidencial. Revisa qué muestra la vista del índice a cada grupo de permisos, no solo qué muestran los archivos. Para un panorama más amplio, la guía de funciones de IA en data rooms compara indexación, búsqueda, resúmenes y tachado.
Qué probar durante la prueba gratuita
Las salas de demostración se arman con archivos prolijos. Los tuyos no lo son. Arma un paquete de unos cincuenta documentos con los casos incómodos a propósito: dos fotos de contratos firmados, un escaneo con varios tipos de documento, un arrendamiento con su otrosí, un par borrador y versión firmada, una hoja de cálculo sin texto y algunos archivos en un segundo idioma.
Luego observa cinco cosas:
- Cuántos de los cincuenta caen en la carpeta correcta sin ayuda, y si el sistema muestra su nivel de confianza.
- Si el otrosí queda cerca de su contrato y si algo los vincula.
- Cuál del par borrador y firmado queda marcado como vigente.
- Si el paquete mixto se señala como mixto o se archiva en silencio como un solo tipo.
- Si una corrección manual se respeta en cargas posteriores o el sistema la deshace.
Confirma también si la indexación con IA viene incluida en el plan cotizado o se cobra aparte; el precio de la IA en un data room varía más que el de la sala.
Las diferencias entre productos son reales. Datasite combina carga masiva, indexación automática y búsqueda de texto completo para conjuntos muy grandes. Drooms ofrece sugerencias de indexación asistidas por IA, numeración automática y detección de duplicados, pensadas para carteras inmobiliarias multilingües. Ansarada se apoya en una puntuación de preparación que califica la completitud del índice antes del lanzamiento. Ellty incluye herramientas de IA junto con carga masiva, permisos, preguntas y respuestas y registro de auditoría completo, en una sala moderna y completa. Repite la misma prueba en cada candidato y las diferencias saltan rápido.
Quién debería apoyarse en la indexación y quién ir más despacio
El valor de la IA crece con el volumen y la repetición. Un asesor que vende una filial con 15.000 documentos repartidos entre México, Colombia y Chile gana muchísimo con el OCR, la numeración y la primera clasificación, y tiene equipo para revisar. Una venta de cuarenta inmuebles parecidos también, porque los tipos de documento se repiten.
Una empresa que comparte 120 documentos elegidos con tres inversionistas gana mucho menos: archivar a mano dentro de una buena plantilla toma una hora y elimina la revisión. La guía para configurar un data room explica cómo hacerlo bien.
Quienes deben ir más despacio son los equipos con material muy sensible: documentos de clean team, precios compartidos entre competidores, historias clínicas o cualquier archivo cuyo error de ubicación sea un problema regulatorio. Esas carpetas se archivan a mano aunque el resto lo ordene la IA. Si todavía estás eligiendo, nuestra selección de los mejores data rooms para due diligence indica qué productos destacan en herramientas de preparación.
Preguntas frecuentes
¿Qué es la indexación automática con IA en un data room?
Es la lectura, clasificación, nombrado, etiquetado y control automatizados de los documentos al subirlos a un data room virtual. El sistema extrae texto, propone carpeta y título, asigna números y etiquetas y señala problemas como duplicados o escaneos ilegibles. El resultado es un índice borrador que una persona debe revisar antes de invitar a terceros.
¿Qué tan precisa es la clasificación con IA?
Suele ser buena con tipos de documento comunes y bien redactados, y más débil con cartas breves, otrosíes, paquetes escaneados mixtos, hojas de cálculo y archivos en otros idiomas. Depende más de la calidad de tus archivos que del proveedor, así que pruébala con tus propios casos difíciles.
¿Puede la IA mostrarle un documento al postor equivocado?
Sí. Si los permisos se asignan por carpeta, un documento mal archivado hereda las reglas de acceso de la carpeta donde cae. Por eso conviene indexar en un área de preparación y asignar permisos solo después de revisar la estructura.
¿La indexación con IA reemplaza la lista de due diligence?
No. La IA ordena lo que subiste, pero le cuesta notar lo que falta, porque un documento ausente no tiene texto. Recorre tu propia lista frente al índice terminado y marca cada punto como encontrado, no aplica o faltante.
¿Se usan mis documentos para entrenar el modelo?
Depende del proveedor y de los servicios de modelos que use. Pide un compromiso contractual de que tus documentos no se usan para entrenamiento y confirma dónde se procesan, sobre todo si la sala contiene datos personales sujetos al RGPD, la LGPD o la Ley 1581.
